


Nghệ thuật kiểm toán bảo mật Web3.0 của ChatGPT: có gì đó, nhưng không hoàn toàn ở đó


Vào tháng 11 năm 2022, OpenAI đã khởi động một dự án trí tuệ nhân tạo (AI) sáng tạo.
Ngoài việc hữu ích cho việc viết và tóm tắt các bài báo, tạo truyện cười và thơ, ChatGPT còn có thể được sử dụng để gỡ lỗi và tạo mã.
Trong cả năm 2022, thiệt hại về tài sản trong lĩnh vực Web3.0 do các sự cố như tin tặc tấn công và lừa đảo đã vượt quá 3,7 tỷ đô la Mỹ, mức thiệt hại lớn như vậy khiến những người trong ngành phải suy nghĩ: liệu những công nghệ mới như ChatGPT có thể được sử dụng để cải thiện tính bảo mật của mã hợp đồng thông minh.
ZKasino, một nền tảng trò chơi phi tập trung, gần đây đã trải qua quá trình kiểm tra trước thông qua ChatGPT.
ZKasino hy vọng rằng trong khi CertiK tiến hành kiểm toán toàn diện, CertiK sẽ tiến hành đánh giá ban đầu về kết quả của ChatGPT để kiểm tra khả năng của ChatGPT hoạt động như một "kiểm toán viên hợp đồng thông minh" AI.
Vậy kết quả thử nghiệm của ChatGPT là gì?
Nó đã sẵn sàng để đảm nhận công việc của các chuyên gia kiểm toán mã nguồn nhân lực chưa?
Hay nó vẫn chưa đủ để thay thế hoàn toàn sức lao động của con người?
Vào ngày 23 tháng 12 năm 2022, ZKasino đã "thuê" ChatGPT để xác định các rủi ro bảo mật tiềm ẩn trong hợp đồng thông minh. Công cụ này gây ra một số lo ngại về rủi ro có vẻ hợp pháp.
Tuy nhiên, mặc dù không thể phủ nhận ChatGPT đã cung cấp một số dịch vụ có giá trị để mã Web3.hoạt động tốt. Tại đây, chúng tôi hy vọng rằng dữ liệu chuyên sâu và đề xuất của các chuyên gia bảo mật CertiK có thể giúp ChatGPT trở thành một công cụ bảo mật ứng dụng Web3.0 mạnh mẽ hơn.
Dưới đây, chúng tôi sẽ giới thiệu chi tiết về hai loại phát hiện sai của ChatGPT trong vụ việc này.
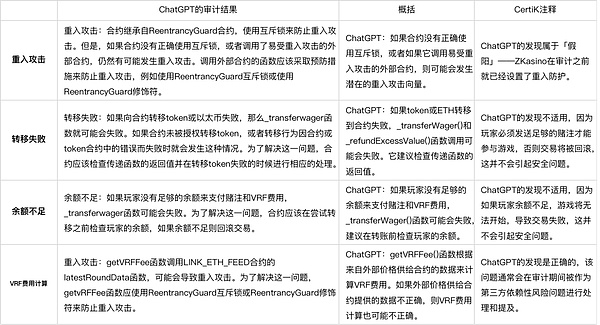
ChatGPT đã tìm thấy vấn đề gì trong hợp đồng?
tiêu đề phụ
Lỗ hổng nghiêm trọng hay nghiêm trọng?
ChatGPT đề cập đến một số vấn đề bảo mật phổ biến tồn tại trong nhiều triển khai hợp đồng thông minh.
Tuy nhiên, nó không xác định được một số rủi ro nghiêm trọng, bao gồm:
Lỗ hổng logic cụ thể của dự án
Tính toán toán học và mô hình thống kê không chính xác
Sự không nhất quán giữa việc triển khai mã và thiết kế dự án
Lỗi #1: Các vấn đề logic dành riêng cho dự án
ChatGPT không xác định được lỗ hổng nghiêm trọng cho phép kẻ tấn công liên tục giành được và rút tiền của người dùng trong hợp đồng Bankroll. Người chơi có thể tham gia trò chơi bằng cách gọi Hàm ngẫu nhiên có thể xác minh (VRF) và VRF của Chainlink sẽ sử dụng các số ngẫu nhiên để kích hoạt hàmfillRandomWords() để hoàn thành trò chơi.
Mã của ZKasino cho phép người dùng lấy lại tiền nếu lệnh gọifillRandomWords() không thành công.
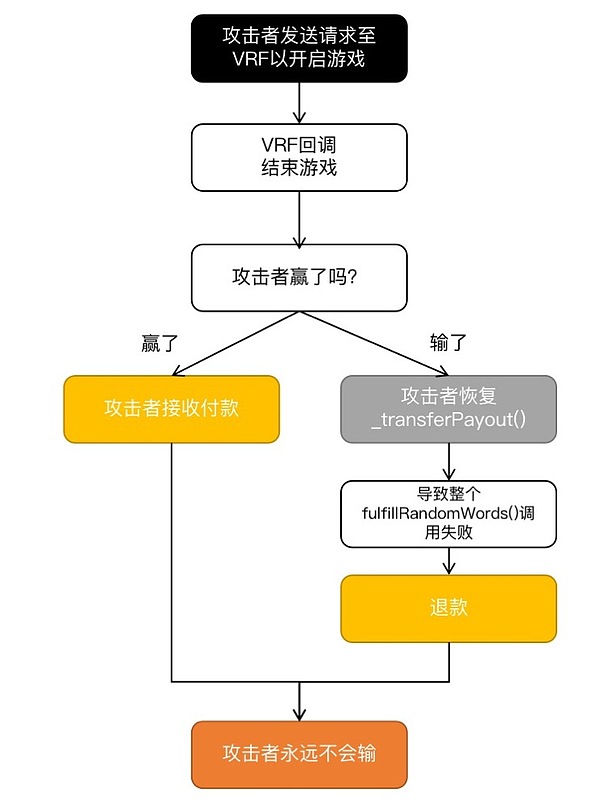
Trong quá trình CertiK xem xét mã hợp đồng thông minh tương tự, lệnh gọi _transferPayout() có khả năng gây hại đã được phát hiện, một chức năng được thiết kế để chuyển tiền thắng cược vào tài khoản của người chơi.
Tuy nhiên, kẻ tấn công có thể gọi _transferPayout() để quay lại khi thua cuộc, khiến toàn bộ lệnh gọifillRandomWords() thất bại-điều này sẽ khiến nó bước vào khoảng thời gian chờ 100 khối và sau đó kích hoạt CoinFlip_Refund() trả lại tiền, điều đó có nghĩa là kẻ tấn công sẽ không bao giờ mất tiền.
Mặc dù ChatGPT đã biết về vấn đề lỗi cuộc gọi, nhưng nó đã không phát hiện ra phương thức tấn công khai thác lỗi cuộc gọi trong dự án này.
Do đó, ChatGPT đã không thấy tác động của lỗ hổng này kết hợp với logic của dự án. Để biết mô tả về luồng tấn công cụ thể, hãy xem báo cáo kiểm toán đầy đủ của ZKasino.
Lỗ hổng #2: Tính toán toán học và mô hình thống kê không chính xác
Đảm bảo rằng tính ngẫu nhiên và kết quả đáp ứng các kỳ vọng hợp lý là rất quan trọng trong bất kỳ dự án trò chơi nào. Để xác nhận điều này, cần phải đánh giá đầy đủ tính ngẫu nhiên của tất cả các kết quả trò chơi trong quá trình kiểm tra.
Mặc dù ChatGPT cũng "đồng ý" về tầm quan trọng của việc này nhưng không tìm thấy bất kỳ kết quả trò chơi không công bằng nào. Nó đề cập đến việc sử dụng VRF và các kết quả không công bằng có thể xảy ra nếu hợp đồng VRF bị phá vỡ hoặc bị thao túng:
"Nếu hợp đồng VRF không an toàn hoặc bị thao túng, điều đó có thể dẫn đến kết quả không công bằng trong trò chơi."
Tuy nhiên, kết luận này chỉ là một kết luận và không thực sự giải quyết nguyên nhân gốc rễ của kết quả trò chơi không công bằng. Và chúng tôi cũng nhận thấy một số vấn đề tiềm ẩn rủi ro về tính ngẫu nhiên trong quá trình kiểm toán.
ngẫu nhiên không công bằng
Một trong những rủi ro cấp trung bình được phát hiện liên quan đến tính ngẫu nhiên là việc sử dụng không công bằng các số ngẫu nhiên trong các trò chơi VideoPoker, nơi người chơi có ít cơ hội nhận được một số quân bài nhất định.
cắt ngắn thập phân
Một vấn đề rủi ro khác được tìm thấy trong các trò chơi giống như xúc xắc cho phép người chơi chọn các hệ số nhân cụ thể để tối đa hóa phần thưởng mong đợi của họ.
Lỗ hổng #3: Sự không nhất quán giữa việc triển khai mã và thiết kế dự án
ChatGPT thường có thể hiểu được việc triển khai một chức năng duy nhất, nhưng không thể hiểu được nguyên nhân cốt lõi của nó.
Ví dụ: nó có thể hiểu cách một chức năng nhất định được thực thi ở cấp độ kỹ thuật, nhưng nó không thể hiểu mục đích của chức năng đó trong toàn bộ hợp đồng thông minh.
Để đảm bảo rằng ChatGPT không gặp vấn đề gì khi viết mã, nó cần hiểu rõ hơn về logic mã của hợp đồng thông minh.
Như hiện tại, ChatGPT cung cấp cách đọc mã hời hợt. Để thực hiện công việc kiểm toán và nâng cấp lên cấp độ tiếp theo, nó phải học cách suy luận logic ban đầu từ một hàm ngược lại - điều này rất quan trọng.
xác thực đầu vào không chính xác
Chúng tôi đã tìm thấy sự cố xác thực đầu vào trong hợp đồng Plinko khiến hệ số nhân bị đặt không chính xác.
Theo ZKasino, số lượng dòng được sử dụng trong Plinko nên từ 8 đến 16. Tuy nhiên, do có lỗi trong lần kiểm tra sau, chủ sở hữu hợp đồng Bankroll có thể đặt giá trị dòng nằm ngoài phạm vi dự kiến thông qua hàm setPlinkoMultipliers().
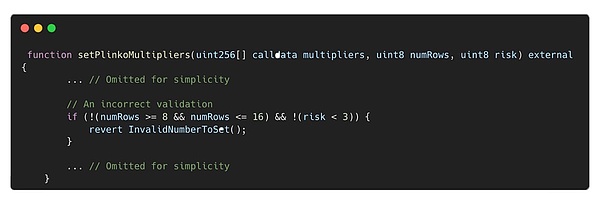
Mã cho thấy rằng nếu cả numRows và rủi ro đều không đáp ứng điều kiện, quy trình sẽ được khôi phục.
Tuy nhiên, nếu chỉ một trong hai điều kiện không được đáp ứng, kiểm tra sẽ vẫn vượt qua và mã sẽ không được khôi phục.
ChatGPT đưa ra một câu trả lời khác cho câu hỏi thứ hai: hàm kiểm tra xem giá trị của "numRows" có nằm trong khoảng từ 8 đến 16 hay không và liệu giá trị của "rủi ro" có nhỏ hơn 3 hay không. Nếu bất kỳ điều kiện nào ở trên không được đáp ứng, hàm sẽ trả về lỗi "InvalidNumberToSet".
ChatGPT dường như hiểu mục đích của chức năng này. Tuy nhiên, nó không có kiến thức ứng dụng để xác định các lỗ hổng thực sự mà không có thông tin bổ sung.
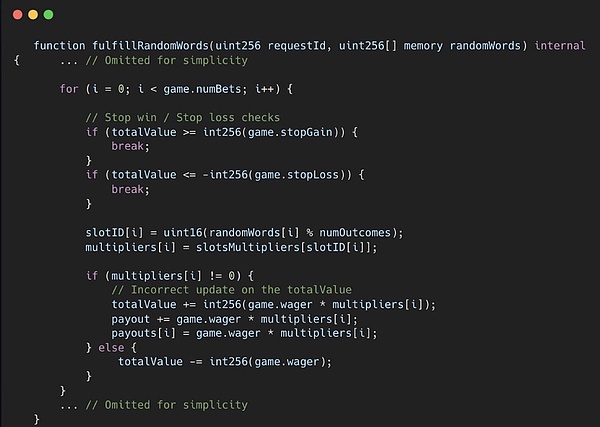
Sự không nhất quán trong cập nhật giá trị
viết ở cuối
viết ở cuối
Mặc dù được đào tạo phù hợp, ChatGPT đã bỏ sót một số vấn đề bảo mật quan trọng trong quá trình kiểm tra. Điều này là do những hạn chế của trí tuệ nhân tạo trong việc hiểu đầy đủ sự phức tạp và sắc thái của mã, cũng như việc nó thiếu kinh nghiệm thực tế trong các tình huống trong thế giới thực.
Như đã nêu trên trang web chính thức của mình, ChatGPT là phiên bản nghiên cứu dựa trên quá trình xử lý ngôn ngữ tự nhiên cho các cuộc hội thoại. Nó thường không thể hiểu mục đích và lập luận logic đằng sau mã giống như cách mà các chuyên gia kiểm toán con người có thể hiểu được.
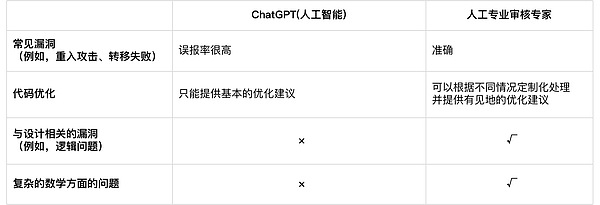
Do đó, điều quan trọng là phải bổ sung phân tích của ChatGPT bằng kiểm tra thủ công bởi các chuyên gia bảo mật có kinh nghiệm để đảm bảo độ chính xác tổng thể.
Hình dưới đây nêu bật những điểm mạnh và điểm yếu của các dịch vụ dựa trên con người và ChatGPT trên các tiêu chí khác nhau.
Giống như chúng tôi sử dụng bản dịch Baidu, độ chính xác của kết quả dịch tiếng Anh thường phụ thuộc vào từ ngữ tiếng Trung của chúng tôi - hiệu quả của các câu trả lời ChatGPT phụ thuộc phần lớn vào lời nhắc (lời nhắc là một phương thức trong ngôn ngữ javascript, công dụng chính là hiển thị hộp thoại lời nhắc ).
Trong bài báo này, chúng tôi so sánh kết quả kiểm toán trước của ZKasino tương tác với ChatGPT với kết quả kiểm tra cuối cùng do các chuyên gia CertiK thực hiện.
Khi công nghệ tiến bộ và hiểu rõ hơn về kỹ thuật nhanh chóng xuất hiện, các kỹ sư sẽ có thể sử dụng ChatGPT tốt hơn.
Trong lần phát hành tiếp theo của tài khoản công khai chính thức của CertiK, chúng tôi sẽ thảo luận với bạn nội dung chuyên sâu hơn về dự án nhanh chóng về cách đặt câu hỏi hiệu quả cho ChatGPT.
Nhưng giờ đây, ChatGPT thậm chí có thể giúp chúng ta tham gia cuộc thi cướp cờ: [Tôi để AI viết bài, phân tích mã và thậm chí thi đấu trong CTF để bắt cờ cho tôi!】Chào mừng bạn nhấp vào để đọc!





