Foresight Ventures: Một cái nhìn hợp lý về mạng điện toán phi tập trung


tiêu đề cấp đầu tiên
TL;DR
Hiện tại, có hai hướng chính cho sự kết hợp giữa AI + Crypto: sức mạnh tính toán phân tán và ZKML; đối với ZKML, vui lòng tham khảo bài viết trước của tôi.Bài viết này sẽ phân tích và phản ánh về mạng điện toán phân tán phi tập trung。
Theo xu hướng phát triển của các mô hình lớn AI,Tài nguyên điện toán sẽ là chiến trường lớn trong thập kỷ tới và cũng là điều quan trọng nhất đối với xã hội loài người trong tương lai, và không chỉ duy trì vị thế cạnh tranh thương mại, mà còn trở thành nguồn lực chiến lược cho trò chơi của các cường quốc. Trong tương lai, đầu tư vào cơ sở hạ tầng điện toán hiệu suất cao và dự trữ năng lượng điện toán sẽ tăng theo cấp số nhân.
Mạng điện toán phân tán phi tập trung có nhu cầu lớn nhất về đào tạo mô hình AI lớn, nhưng nó cũng phải đối mặt với những thách thức lớn nhất và tắc nghẽn kỹ thuật. Kể cả nhu cầu đồng bộ dữ liệu phức tạp và vấn đề tối ưu hóa mạng. Ngoài ra, quyền riêng tư và bảo mật dữ liệu cũng là những ràng buộc quan trọng. Mặc dù có một số kỹ thuật hiện có có thể cung cấp các giải pháp sơ bộ, nhưng chúng vẫn không thể áp dụng trong các nhiệm vụ đào tạo phân tán quy mô lớn do chi phí tính toán và truyền thông rất lớn.
Mạng điện toán phân tán phi tập trung có cơ hội tiếp cận lý luận mô hình tốt hơn và nó có thể dự đoán rằng không gian gia tăng trong tương lai cũng đủ lớn. Nhưng nó cũng phải đối mặt với những thách thức như độ trễ giao tiếp, quyền riêng tư dữ liệu và bảo mật mô hình. So với đào tạo mô hình, suy luận có độ phức tạp tính toán và tương tác dữ liệu thấp hơn và phù hợp hơn với môi trường phân tán.
tiêu đề cấp đầu tiên
1. Sức mạnh tính toán phân tán — Đào tạo mô hình lớn
Chúng tôi đang thảo luận về ứng dụng của sức mạnh tính toán phân tán trong đào tạo và thường tập trung vào việc đào tạo các mô hình ngôn ngữ lớn. Lý do chính là việc đào tạo các mô hình nhỏ không yêu cầu nhiều sức mạnh tính toán. Để thực hiện quyền riêng tư dữ liệu phân tán và một loạt của các dự án Vấn đề không hiệu quả về chi phí, tốt hơn là giải quyết nó một cách trực tiếp và tập trung. Mô hình ngôn ngữ lớn có nhu cầu rất lớn về sức mạnh tính toán, hiện đang ở giai đoạn đầu của sự bùng nổ, từ năm 2012 đến năm 2018, nhu cầu tính toán AI sẽ tăng gấp đôi sau mỗi 4 tháng, hiện là điểm tập trung của nhu cầu năng lượng tính toán , có thể dự đoán Đánh giá rằng 5-8 năm tới vẫn sẽ là một nhu cầu gia tăng rất lớn.
tiêu đề phụ
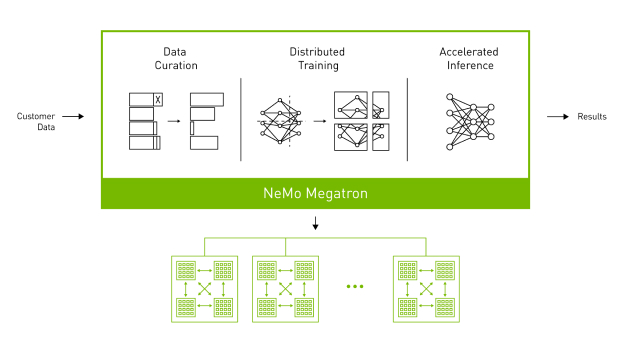
(NVIDIA NeMo Megatron Framework)
1. Tổng thể quá trình đào tạo
Lấy ví dụ đào tạo một mô hình lớn với 175 tỷ tham số. Do mô hình có kích thước lớn nên cần đào tạo song song trên nhiều thiết bị GPU. Giả sử có một phòng máy tính tập trung với 100 GPU và mỗi thiết bị có bộ nhớ 32 GB.
chuẩn bị dữ liệu: Trước hết, cần có một tập dữ liệu khổng lồ, chứa nhiều dữ liệu khác nhau như thông tin Internet, tin tức, sách, v.v. Những dữ liệu này cần được xử lý trước khi đào tạo, bao gồm làm sạch văn bản, mã thông báo, xây dựng từ vựng, v.v.
phân đoạn dữ liệu: Dữ liệu sau khi xử lý sẽ được chia thành nhiều đợt để xử lý song song trên nhiều GPU. Giả sử kích thước lô đã chọn là 512, nghĩa là mỗi lô chứa 512 chuỗi văn bản. Sau đó, chúng tôi chia toàn bộ tập dữ liệu thành các lô, tạo thành một hàng các lô.
Truyền dữ liệu giữa các thiết bị: Khi bắt đầu mỗi bước huấn luyện, CPU sẽ tìm nạp một lô từ hàng đợi lô, sau đó gửi dữ liệu của lô này tới GPU thông qua bus PCIe. Giả sử độ dài trung bình của mỗi chuỗi văn bản là 1024 mã thông báo, kích thước dữ liệu của mỗi đợt xấp xỉ 512 * 1024 * 4 B = 2 MB (giả sử mỗi mã thông báo được biểu thị bằng một số dấu phẩy động có độ chính xác đơn 4 byte). Quá trình truyền dữ liệu này thường chỉ mất vài mili giây.
đào tạo song song: Sau khi mỗi thiết bị GPU nhận được dữ liệu, nó bắt đầu thực hiện các phép tính chuyển tiếp và chuyển tiếp ngược, đồng thời tính toán độ dốc của từng tham số. Do kích thước lớn của mô hình, bộ nhớ của một GPU không thể lưu trữ tất cả các tham số, vì vậy chúng tôi sử dụng công nghệ song song mô hình để phân phối các tham số mô hình trên nhiều GPU.
Tập hợp Gradient và Cập nhật thông số: Sau khi tính toán lan truyền ngược hoàn tất, mỗi GPU sẽ nhận được độ dốc của một phần tham số. Sau đó, các độ dốc này cần được tổng hợp trên tất cả các thiết bị GPU để tính toán độ dốc toàn cầu. Điều này yêu cầu truyền dữ liệu qua mạng và giả sử mạng 25 Gbps, sẽ mất khoảng 224 giây để truyền 700 GB dữ liệu (khoảng 700 GB cho 175 tỷ tham số, giả sử dấu phẩy động có độ chính xác duy nhất cho từng tham số). Sau đó, mỗi GPU sẽ cập nhật các tham số được lưu trữ của nó theo độ dốc toàn cầu.
Làm cho đồng bộ: Sau khi các tham số được cập nhật, tất cả các thiết bị GPU cần được đồng bộ hóa để đảm bảo rằng tất cả chúng đều sử dụng các tham số mô hình nhất quán cho bước đào tạo tiếp theo. Điều này cũng yêu cầu truyền dữ liệu qua mạng.
Lặp lại các bước đào tạo: Lặp lại các bước trên cho đến khi hoàn tất quá trình huấn luyện của tất cả các đợt hoặc đạt đến số vòng huấn luyện (kỷ nguyên) đã xác định trước.
tiêu đề phụ
2. Điểm nghẽn về chi phí truyền thông:
Cần lưu ý rằng nút thắt cổ chai trong truyền thông cũng là nguyên nhân của mạng điện toán phân tán hiện naykhông thể làm điều nàyLý do đào tạo mô hình ngôn ngữ lớn.
Mỗi nút cần trao đổi thông tin thường xuyên để làm việc cùng nhau, điều này tạo ra chi phí truyền thông. Đối với các mô hình ngôn ngữ lớn, vấn đề này đặc biệt nghiêm trọng do số lượng lớn các tham số của mô hình. Chi phí truyền thông được chia thành các khía cạnh sau:
truyền dữ liệu: Các nút cần thường xuyên trao đổi thông số mô hình và thông tin độ dốc trong quá trình huấn luyện. Điều này đòi hỏi phải truyền một lượng lớn dữ liệu trong mạng, tiêu tốn một lượng lớn băng thông mạng. Nếu điều kiện mạng kém hoặc khoảng cách giữa các nút tính toán lớn, độ trễ truyền dữ liệu sẽ cao, làm tăng thêm chi phí liên lạc.
sự cố đồng bộ hóa: Trong quá trình đào tạo, các nút cần phải làm việc cùng nhau để đảm bảo đào tạo chính xác. Điều này đòi hỏi các hoạt động đồng bộ hóa thường xuyên giữa các nút, chẳng hạn như cập nhật các tham số mô hình, tính toán độ dốc toàn cầu, v.v. Các hoạt động đồng bộ này cần truyền một lượng lớn dữ liệu trong mạng và cần đợi tất cả các nút hoàn thành hoạt động, điều này sẽ gây ra nhiều chi phí liên lạc và thời gian chờ đợi.
Tích lũy và cập nhật gradient: Trong quá trình đào tạo, mỗi nút cần tính toán độ dốc của riêng mình và gửi nó đến các nút khác để tích lũy và cập nhật. Điều này đòi hỏi phải truyền một lượng lớn dữ liệu độ dốc trong mạng và cần phải đợi tất cả các nút hoàn thành việc tính toán và truyền độ dốc, đây cũng là lý do gây ra một lượng lớn chi phí liên lạc.
tính nhất quán của dữ liệu: Cần đảm bảo rằng các tham số mô hình của mỗi nút là nhất quán. Điều này đòi hỏi các hoạt động đồng bộ hóa và kiểm tra dữ liệu thường xuyên giữa các nút, dẫn đến một lượng lớn chi phí liên lạc.
Mặc dù có một số phương pháp để giảm chi phí truyền thông, chẳng hạn như nén tham số và độ dốc, chiến lược song song hiệu quả, v.v., những phương pháp này có thể tạo thêm gánh nặng tính toán hoặc ảnh hưởng tiêu cực đến hiệu quả đào tạo của mô hình. Ngoài ra, các phương pháp này không thể giải quyết hoàn toàn vấn đề chi phí liên lạc, đặc biệt trong trường hợp điều kiện mạng kém hoặc khoảng cách lớn giữa các nút tính toán.
Như một ví dụ:
Mạng điện toán phân tán phi tập trung
Mô hình GPT-3 có 175 tỷ tham số và nếu chúng tôi biểu thị các tham số này bằng cách sử dụng các số dấu phẩy động có độ chính xác đơn (4 byte cho mỗi tham số), thì việc lưu trữ các tham số này cần ~700 GB bộ nhớ. Trong đào tạo phân tán, các tham số này cần được truyền và cập nhật thường xuyên giữa các nút tính toán.
Giả sử có 100 nút tính toán, mỗi nút cần cập nhật tất cả các tham số trong mỗi bước, sau đó mỗi bước cần truyền khoảng 70 TB (700 GB* 100 ) dữ liệu. Nếu chúng ta giả định rằng một bước mất 1 giây (giả định rất lạc quan), thì 70 TB dữ liệu cần được truyền mỗi giây. Nhu cầu về băng thông này đã vượt xa nhu cầu của hầu hết các mạng và cũng là một vấn đề về tính khả thi.
Trong thực tế, do sự chậm trễ trong giao tiếp và tắc nghẽn mạng, thời gian truyền dữ liệu có thể lâu hơn 1 giây. Điều này có nghĩa là các nút điện toán có thể cần dành nhiều thời gian chờ truyền dữ liệu thay vì thực hiện các phép tính thực tế. Điều này sẽ làm giảm đáng kể hiệu quả của đào tạo và việc giảm hiệu quả này không thể được giải quyết bằng cách chờ đợi mà là sự khác biệt giữa khả thi và không khả thi, điều này sẽ khiến toàn bộ quá trình đào tạo trở nên không khả thi.
Phòng máy tính tập trung
Ngay cả trong môi trường phòng máy tính tập trung, việc đào tạo các mô hình lớn vẫn đòi hỏi tối ưu hóa giao tiếp nặng nề.
Trong môi trường phòng máy tính tập trung, các thiết bị tính toán hiệu suất cao được sử dụng như một cụm, được kết nối thông qua mạng tốc độ cao để chia sẻ các tác vụ tính toán. Tuy nhiên, ngay cả khi đào tạo một mô hình với số lượng tham số cực lớn trong môi trường mạng tốc độ cao như vậy, chi phí truyền thông vẫn là một nút cổ chai, bởi vì các tham số và độ dốc của mô hình cần được truyền và cập nhật thường xuyên giữa các thiết bị máy tính khác nhau .
Như đã đề cập ở phần đầu, giả sử có 100 nút tính toán với băng thông mạng 25 Gbps trên mỗi máy chủ. Nếu mỗi máy chủ cần cập nhật tất cả các thông số trong mỗi bước đào tạo, thì sẽ mất ~224 giây để truyền khoảng 700 GB dữ liệu cho mỗi bước đào tạo. Bằng cách tận dụng phòng máy tính tập trung, các nhà phát triển có thể tối ưu hóa cấu trúc liên kết mạng bên trong trung tâm dữ liệu và sử dụng các công nghệ như mô hình song song để giảm đáng kể thời gian này.
Ngược lại, nếu quá trình đào tạo tương tự được thực hiện trong môi trường phân tán, giả sử vẫn còn 100 nút điện toán được phân phối trên toàn thế giới, thì băng thông mạng trung bình của mỗi nút chỉ là 1 Gbps. Trong trường hợp này, phải mất ~5600 giây để truyền cùng 700 GB dữ liệu, lâu hơn nhiều so với trong phòng máy tính tập trung. Ngoài ra, do sự chậm trễ và tắc nghẽn mạng, thời gian thực tế cần thiết có thể lâu hơn.
Tuy nhiên, so với tình huống trong mạng điện toán phân tán, việc tối ưu hóa chi phí liên lạc trong môi trường phòng máy tính tập trung là tương đối dễ dàng. Bởi vì trong môi trường phòng máy tính tập trung, các thiết bị máy tính thường được kết nối với cùng một mạng tốc độ cao, băng thông và độ trễ của mạng tương đối tốt. Trong một mạng điện toán phân tán, các nút điện toán có thể được phân phối trên toàn thế giới và điều kiện mạng có thể tương đối kém, điều này làm cho vấn đề chi phí liên lạc trở nên nghiêm trọng hơn.
tiêu đề phụ
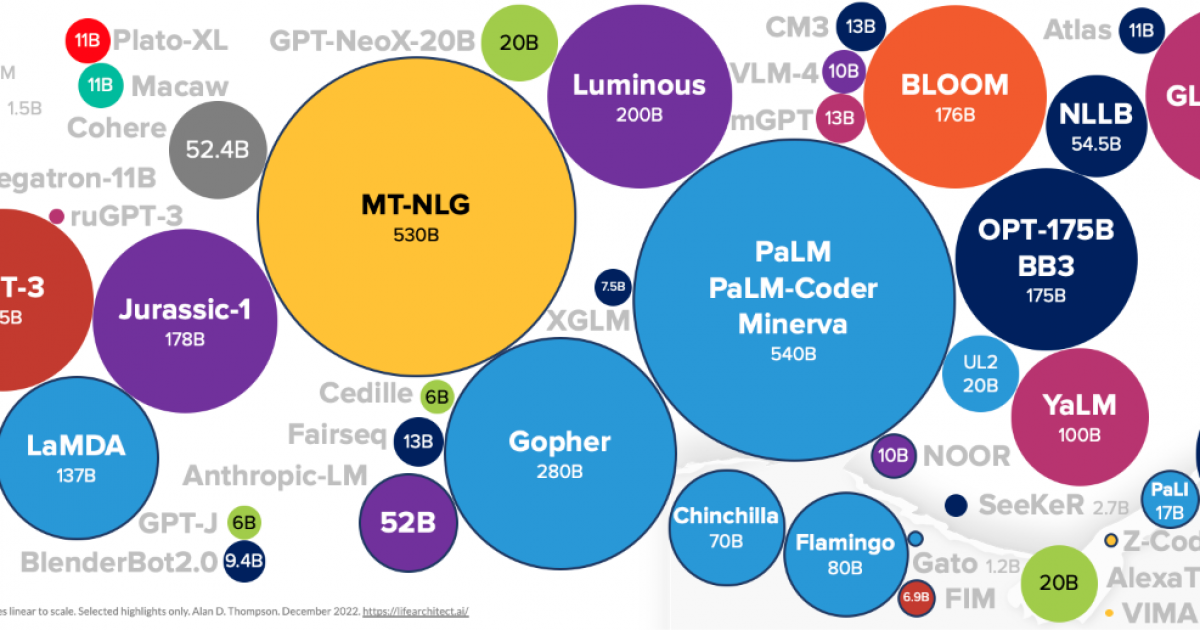
(Data used to train LLM models)
3. Tại sao mạng điện toán phân tán không thể thực hiện các tối ưu hóa này
Nó có thể được thực hiện, nhưng so với phòng máy tính tập trung, hiệu quả của những tối ưu hóa này là rất hạn chế.
1. Tối ưu hóa cấu trúc liên kết mạng: Trong phòng máy tính tập trung, phần cứng và bố cục mạng có thể được kiểm soát trực tiếp, do đó cấu trúc liên kết mạng có thể được thiết kế và tối ưu hóa theo nhu cầu. Tuy nhiên, trong một môi trường phân tán, các nút điện toán được phân bổ ở các vị trí địa lý khác nhau, thậm chí một ở Trung Quốc và một ở Hoa Kỳ và không có cách nào để kiểm soát trực tiếp kết nối mạng giữa chúng. Mặc dù phần mềm có thể được sử dụng để tối ưu hóa đường truyền dữ liệu, nhưng nó không hiệu quả bằng việc tối ưu hóa trực tiếp mạng phần cứng. Đồng thời, do sự khác biệt về vị trí địa lý, độ trễ mạng và băng thông cũng khác nhau rất nhiều, điều này càng hạn chế hiệu quả của việc tối ưu hóa cấu trúc liên kết mạng.
2. mô hình song songtiêu đề phụ
4. Thách thức về bảo mật dữ liệu và quyền riêng tư
Hầu như tất cả các liên kết liên quan đến xử lý và truyền dữ liệu đều có thể ảnh hưởng đến bảo mật và quyền riêng tư của dữ liệu:
1. phân phối dữ liệu: Dữ liệu huấn luyện cần được phân phối cho từng nút tham gia tính toán. Dữ liệu trong liên kết này có thể bị sử dụng/rò rỉ một cách ác ý trên các nút phân tán.
2. đào tạo người mẫu: Trong quá trình đào tạo, mỗi nút sẽ sử dụng dữ liệu được chỉ định của nó để tính toán, sau đó xuất bản cập nhật hoặc độ dốc của các tham số mô hình. Trong quá trình này, nếu quá trình tính toán của nút bị đánh cắp hoặc kết quả bị phân tích ác ý, dữ liệu cũng có thể bị rò rỉ.
3. Tham số và Tập hợp Gradient: Đầu ra của các nút riêng lẻ cần được tổng hợp để cập nhật mô hình toàn cầu và giao tiếp trong quá trình tổng hợp cũng có thể làm rò rỉ thông tin về dữ liệu huấn luyện.
Các giải pháp cho mối quan tâm về quyền riêng tư dữ liệu là gì?
Tính toán đa bên an toàn: SMC đã được áp dụng thành công trong một số nhiệm vụ tính toán cụ thể, quy mô nhỏ. Tuy nhiên, trong các nhiệm vụ đào tạo phân tán quy mô lớn, do chi phí tính toán và truyền thông lớn nên nó vẫn chưa được sử dụng rộng rãi.
Quyền riêng tư khác biệt: Được áp dụng trong một số tác vụ thu thập và phân tích dữ liệu nhất định, chẳng hạn như thống kê người dùng của Chrome. Nhưng trong các nhiệm vụ học sâu quy mô lớn, DP sẽ có tác động đến độ chính xác của mô hình. Đồng thời, nó cũng là một thách thức để thiết kế một cơ chế tạo và bổ sung tiếng ồn phù hợp.
Học liên kết: Áp dụng cho một số tác vụ đào tạo mô hình thiết bị cạnh, chẳng hạn như dự đoán từ vựng cho bàn phím Android, v.v. Nhưng trong các nhiệm vụ đào tạo phân tán quy mô lớn hơn, FL phải đối mặt với các vấn đề như chi phí liên lạc cao và sự phối hợp phức tạp.
Mã hóa đồng cấu: Đã được áp dụng thành công trong một số tác vụ có độ phức tạp tính toán nhỏ. Tuy nhiên, trong các nhiệm vụ đào tạo phân tán quy mô lớn, do chi phí tính toán cao nên nó vẫn chưa được sử dụng rộng rãi.
tóm tắt
Mỗi phương pháp trên đều có các kịch bản và giới hạn có thể áp dụng, và không có phương pháp nào có thể giải quyết hoàn toàn vấn đề bảo mật dữ liệu trong đào tạo mô hình lớn của mạng điện toán phân tán.
ZK, công ty có nhiều hy vọng, có thể giải quyết vấn đề bảo mật dữ liệu trong đào tạo mô hình lớn không?
Về lý thuyết, ZKP có thể được sử dụng để đảm bảo quyền riêng tư dữ liệu trong điện toán phân tán, cho phép một nút chứng minh rằng nó đã thực hiện các phép tính theo quy định, nhưng không cần tiết lộ dữ liệu đầu vào và đầu ra thực tế.
Nhưng trên thực tế, các nút thắt sau phải đối mặt trong kịch bản sử dụng ZKP cho các mô hình lớn đào tạo mạng điện toán phân tán quy mô lớn:
Chi phí tính toán và truyền thông tăng: Xây dựng và xác minh bằng chứng không kiến thức đòi hỏi tài nguyên máy tính lớn. Ngoài ra, ZKP có chi phí liên lạc cao do cần phải tự truyền bằng chứng. Những chi phí này có thể trở nên đặc biệt quan trọng trong trường hợp đào tạo mô hình lớn. Ví dụ: nếu tính toán của từng lô nhỏ yêu cầu tạo bằng chứng, điều này có thể làm tăng đáng kể tổng thời gian và chi phí đào tạo.
Độ phức tạp của giao thức ZK: Việc thiết kế và triển khai giao thức ZKP phù hợp với đào tạo mô hình lớn có thể rất phức tạp. Giao thức này cần có khả năng xử lý dữ liệu quy mô lớn và các tính toán phức tạp, đồng thời nó cần có khả năng xử lý các lỗi bất thường có thể xảy ra.
Tương thích phần cứng và phần mềm: Việc sử dụng ZKP yêu cầu hỗ trợ phần cứng và phần mềm cụ thể, có thể không có sẵn trên tất cả các thiết bị máy tính phân tán.
tóm tắt
tiêu đề cấp đầu tiên
2. Sức mạnh tính toán phân tán—Lập luận mô hình
Một kịch bản tương đối lớn khác của sức mạnh tính toán phân tán là suy luận mô hình. Theo nhận định của chúng tôi về lộ trình phát triển của các mô hình lớn, nhu cầu đào tạo mô hình sẽ dần chậm lại khi các mô hình lớn trưởng thành sau khi vượt qua điểm cao. Yêu cầu suy luận sẽ tương ứng tăng theo cấp số nhân với sự trưởng thành của các mô hình lớn và AIGC.
tiêu đề phụ

(Power LLM inference with NVIDIA Triton)
1. Thử thách
Độ trễ giao tiếp:
Trong một môi trường phân tán, giao tiếp giữa các nút là điều cần thiết. Trong một mạng điện toán phân tán phi tập trung, các nút có thể trải rộng khắp thế giới, do đó, độ trễ của mạng có thể là một vấn đề, đặc biệt đối với các tác vụ lý luận yêu cầu phản hồi theo thời gian thực.
Triển khai và cập nhật mô hình:
Mô hình cần được triển khai cho từng nút. Nếu mô hình được cập nhật, mỗi nút cần cập nhật mô hình của nó, điều này tiêu tốn rất nhiều băng thông mạng và thời gian.
Bảo mật dữ liệu:
Mặc dù các tác vụ suy luận thường chỉ yêu cầu dữ liệu đầu vào và mô hình và không cần trả lại một lượng lớn dữ liệu và tham số trung gian, nhưng dữ liệu đầu vào vẫn có thể chứa thông tin nhạy cảm, chẳng hạn như thông tin cá nhân của người dùng.
Bảo mật mô hình:
Trong một mạng phi tập trung, mô hình cần được triển khai trên các nút không đáng tin cậy, điều này sẽ dẫn đến rò rỉ mô hình và dẫn đến vấn đề lạm dụng và quyền sở hữu mô hình. Điều này cũng có thể gây lo ngại về bảo mật và quyền riêng tư, nếu một mô hình được sử dụng để xử lý dữ liệu nhạy cảm, các nút có thể suy ra thông tin nhạy cảm bằng cách phân tích hành vi của mô hình.
QC:
tiêu đề phụ
2. Tính khả thi
Độ phức tạp tính toán:
Trong giai đoạn huấn luyện, mô hình cần lặp đi lặp lại nhiều lần, trong quá trình huấn luyện cần tính toán lan truyền xuôi và lan truyền ngược của từng lớp, bao gồm tính hàm kích hoạt, tính hàm mất mát, tính hàm độ dốc và cập nhật trọng lượng. Do đó, độ phức tạp tính toán của đào tạo mô hình là cao.
Trong giai đoạn suy luận, chỉ cần một lần chuyển tiếp để tính toán dự đoán. Ví dụ: trong GPT-3, văn bản đầu vào cần được chuyển đổi thành một vectơ, sau đó được chuyển tiếp qua từng lớp của mô hình (thường là lớp Biến áp) và cuối cùng thu được phân phối xác suất đầu ra và từ tiếp theo được tạo theo sự phân bố này. Trong GAN, mô hình cần tạo hình ảnh từ vectơ nhiễu đầu vào. Các hoạt động này chỉ liên quan đến việc truyền về phía trước của mô hình, không cần tính toán độ dốc hoặc cập nhật tham số và có độ phức tạp tính toán thấp.
Tương tác dữ liệu:
Trong giai đoạn suy luận, mô hình thường xử lý một đầu vào duy nhất thay vì lô dữ liệu lớn trong quá trình đào tạo. Kết quả của mỗi suy luận chỉ phụ thuộc vào đầu vào hiện tại, không phụ thuộc vào đầu vào hoặc đầu ra khác, do đó không cần lượng tương tác dữ liệu lớn và áp lực giao tiếp ít hơn.
Lấy mô hình hình ảnh tổng quát làm ví dụ, giả sử chúng ta sử dụng GAN để tạo hình ảnh, chúng ta chỉ cần nhập một vectơ nhiễu vào mô hình, sau đó mô hình sẽ tạo ra một hình ảnh tương ứng. Trong quá trình này, mỗi đầu vào sẽ chỉ tạo ra một đầu ra và không có sự phụ thuộc giữa các đầu ra nên không cần tương tác dữ liệu.
Lấy GPT-3 làm ví dụ, mỗi thế hệ của từ tiếp theo chỉ yêu cầu đầu vào văn bản hiện tại và trạng thái của mô hình, không cần tương tác với các đầu vào hoặc đầu ra khác, do đó yêu cầu về tương tác dữ liệu cũng yếu.
tóm tắt
tiêu đề cấp đầu tiên
3. Dự án
Mô tả hình ảnh
1.Together
(RedPajama from Together)
Together là một công ty tập trung vào mã nguồn mở của các mô hình lớn và cam kết cung cấp các giải pháp điện toán AI phi tập trung, với hy vọng rằng bất kỳ ai, ở bất kỳ đâu cũng có thể truy cập và sử dụng AI. Together vừa đóng vòng hạt giống trị giá 20 triệu USD do Lux Capital dẫn đầu.
Together do Chris, Percy và Ce đồng sáng lập. Mục đích ban đầu là đào tạo mô hình lớn cần một số lượng lớn cụm GPU cao cấp và chi phí đắt đỏ, đồng thời những tài nguyên và khả năng đào tạo mô hình này cũng tập trung vào một số công ty lớn .
Theo quan điểm của tôi, một kế hoạch kinh doanh hợp lý hơn cho sức mạnh tính toán phân tán là:
Bước 1. Mô hình mã nguồn mở
Để triển khai lý luận mô hình trong mạng điện toán phân tán phi tập trung, điều kiện tiên quyết là các nút phải có khả năng lấy mô hình với chi phí thấp, nghĩa là mô hình sử dụng mạng điện toán phi tập trung cần phải là nguồn mở (nếu mô hình cần phải được cấp phép tương ứng. Nếu sử dụng bên dưới, nó sẽ làm tăng độ phức tạp và chi phí thực hiện). Ví dụ: chatgpt, với tư cách là một mô hình không phải nguồn mở, không phù hợp để thực thi trên mạng điện toán phi tập trung.
Do đó, có thể suy đoán rằng rào cản vô hình của một công ty cung cấp mạng điện toán phi tập trung cần phải có khả năng bảo trì và phát triển mô hình quy mô lớn mạnh mẽ. Mô hình cơ sở mạnh mẽ tự phát triển và mã nguồn mở có thể thoát khỏi sự phụ thuộc vào mô hình nguồn mở của bên thứ ba ở một mức độ nhất định và giải quyết các vấn đề cơ bản nhất của mạng điện toán phi tập trung. Đồng thời, việc chứng minh rằng mạng điện toán có thể thực hiện hiệu quả việc đào tạo và lý luận của các mô hình lớn sẽ thuận lợi hơn.
Và Together cũng làm như vậy. RedPajama dựa trên LLaMA được phát hành gần đây đã được các nhóm bao gồm Together, Ontocord.ai, ETH DS 3 Lab, Stanford CRFM và Hazy Research cùng ra mắt. Mục tiêu là phát triển một loạt các mô hình ngôn ngữ lớn mã nguồn mở hoàn toàn.
Bước 2. Triển khai sức mạnh tính toán phân tán trong lý luận mô hình
Như đã đề cập ở hai phần trên, so với đào tạo mô hình, suy luận mô hình có độ phức tạp tính toán và tương tác dữ liệu thấp hơn, đồng thời phù hợp hơn với môi trường phân tán phi tập trung.
Trên cơ sở mô hình mã nguồn mở, nhóm R&D của Together đã thực hiện một loạt cập nhật cho mô hình RedPajama-INCITE-3 B, chẳng hạn như sử dụng LoRA để tinh chỉnh chi phí thấp, giúp mô hình chạy trên CPU (đặc biệt là chiếc MacBook sử dụng vi xử lý M 2 Pro) Pro) để mẫu mã chạy mượt mà hơn. Đồng thời, mặc dù quy mô của mô hình này nhỏ nhưng khả năng của nó vượt xa các mô hình khác có cùng quy mô và nó đã được áp dụng thực tế trong các tình huống pháp lý, xã hội và các tình huống khác.
Mô tả hình ảnh
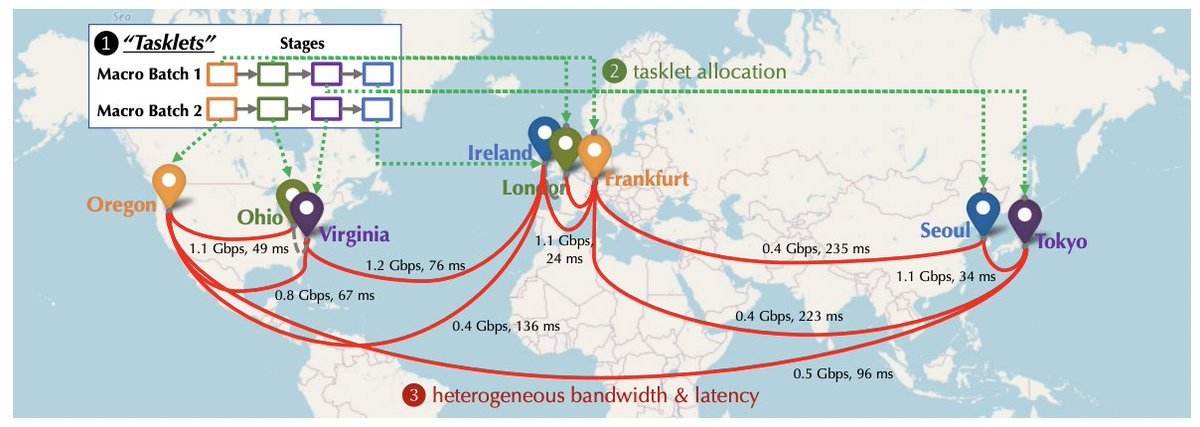
(Sơ đồ mạng điện toán của Vượt qua tắc nghẽn giao tiếp để đào tạo phi tập trung)
Trong trung và dài hạn, mặc dù phải đối mặt với những thách thức lớn và tắc nghẽn kỹ thuật, nhưng nó phải là điều hấp dẫn nhất để đáp ứng nhu cầu về sức mạnh tính toán cho đào tạo mô hình lớn AI. Cùng nhau bắt đầu vạch ra cách vượt qua nút cổ chai giao tiếp trong đào tạo phi tập trung khi mới thành lập. Họ cũng đã xuất bản một bài báo liên quan về NeurIPS 2022:Overcoming Communication Bottlenecks for Decentralized Training. Chúng tôi chủ yếu có thể tóm tắt các hướng sau:
Lập kế hoạch tối ưu hóa
Khi đào tạo trong môi trường phi tập trung, điều quan trọng là phải giao các nhiệm vụ nặng về giao tiếp cho các thiết bị có kết nối nhanh hơn vì kết nối giữa các nút có độ trễ và băng thông khác nhau. Cùng nhau xây dựng một mô hình để mô tả chi phí của một chiến lược lập lịch cụ thể và tối ưu hóa tốt hơn chiến lược lập lịch để giảm thiểu chi phí liên lạc và tối đa hóa thông lượng đào tạo. Nhóm Together cũng nhận thấy rằng ngay cả với mạng chậm hơn 100 lần, thông lượng đào tạo từ đầu đến cuối chỉ chậm hơn từ 1,7 đến 2,3 lần. Do đó, thật thú vị khi bắt kịp khoảng cách giữa các mạng phân tán và các cụm tập trung thông qua tối ưu hóa lập lịch trình.
Tối ưu hóa nén truyền thông
Cùng nhau đề xuất nén giao tiếp để kích hoạt chuyển tiếp và độ dốc ngược, đồng thời giới thiệu thuật toán AQ-SGD, cung cấp các đảm bảo nghiêm ngặt cho sự hội tụ giảm dần độ dốc ngẫu nhiên. AQ-SGD có thể tinh chỉnh các mô hình cơ sở lớn trên các mạng chậm (ví dụ: 500 Mbps) với hiệu suất đào tạo đầu cuối chỉ chậm hơn 31% trên các mạng tập trung (ví dụ: 10 Gbps) mà không cần nén. Ngoài ra, AQ-SGD có thể được kết hợp với các kỹ thuật nén độ dốc hiện đại như QuantizedAdam để đạt được tốc độ đầu cuối 10%.
tóm tắt dự án
Cấu hình nhóm cùng nhau rất toàn diện, các thành viên có nền tảng học thuật rất vững chắc, từ phát triển mô hình lớn, điện toán đám mây đến tối ưu hóa phần cứng đều được hỗ trợ bởi các chuyên gia trong ngành. Và Together đã thể hiện tư thế kiên nhẫn và lâu dài trong việc lập kế hoạch lộ trình, từ phát triển các mô hình lớn nguồn mở đến thử nghiệm sức mạnh tính toán nhàn rỗi (chẳng hạn như mac) trong mạng điện toán phân tán bằng cách sử dụng lý luận mô hình, sau đó phân tán sức mạnh tính toán trong Bố cục lớn trên đào tạo người mẫu. - Có kiểu tích tụ và cảm giác tóc mỏng :)
Mô tả hình ảnh
2.Gensyn.ai
(Gensyn.ai)
Từ lộ trình kỹ thuật của Together, chúng ta có thể hiểu sơ bộ quá trình triển khai mạng điện toán phi tập trung trong đào tạo và lý luận mô hình, cũng như các ưu tiên nghiên cứu và phát triển tương ứng.
Một điểm quan trọng nữa không thể không nhắc đến đó là thiết kế tầng khuyến khích/thuật toán đồng thuận của mạng điện toán, chẳng hạn một mạng xuất sắc cần có:
1. Đảm bảo lợi ích đủ hấp dẫn;
2. Đảm bảo rằng mỗi người khai thác đều nhận được những lợi ích xứng đáng, bao gồm chống gian lận và trả nhiều tiền hơn cho nhiều công việc hơn;
3. Đảm bảo rằng các nhiệm vụ được lên lịch và phân bổ trực tiếp và hợp lý trên các nút khác nhau, và sẽ không có một số lượng lớn các nút nhàn rỗi hoặc quá tải một số nút;
4. Thuật toán khuyến khích đơn giản và hiệu quả, đồng thời sẽ không gây ra gánh nặng và sự chậm trễ quá mức cho hệ thống;
……
Xem cách Gensyn.ai thực hiện:
trở thành một nút
xác minh
xác minh
Bộ giải tạo nhiều điểm kiểm tra trong khi cập nhật tham số (để đảm bảo tính minh bạch và khả năng truy xuất nguồn gốc của công việc) đồng thời tạo định kỳ bằng chứng lý luận mật mã (bằng chứng về tiến độ công việc) về các tác vụ;
Khi Bộ giải hoàn thành công việc và đưa ra một phần kết quả tính toán, giao thức sẽ chọn một người xác minh và người xác minh cũng sẽ cam kết một số tiền nhất định (để đảm bảo rằng người xác minh thực hiện xác minh một cách trung thực) và quyết định phần nào của phép tính kết quả cần phải được xác minh theo các bằng chứng được cung cấp ở trên.
Nếu bộ giải và bộ xác minh khác nhau
Thông qua cấu trúc dữ liệu dựa trên cây Merkle, xác định vị trí chính xác nơi kết quả tính toán phân kỳ. Toàn bộ hoạt động xác minh sẽ diễn ra trên chuỗi và những kẻ gian lận sẽ bị khấu trừ vào số tiền đã cam kết.
tóm tắt dự án
Thiết kế của thuật toán khuyến khích và xác minh giúp Gensyn.ai không cần phát lại tất cả kết quả của toàn bộ tác vụ tính toán trong quá trình xác minh mà chỉ cần sao chép và xác minh một phần kết quả theo bằng chứng được cung cấp, giúp cải thiện đáng kể hiệu quả của việc xác minh. Đồng thời, các nút chỉ cần lưu trữ một phần kết quả tính toán, điều này cũng làm giảm mức tiêu thụ không gian lưu trữ và tài nguyên máy tính. Ngoài ra, các nút gian lận tiềm năng không thể dự đoán phần nào sẽ được chọn để xác minh, vì vậy điều này cũng làm giảm nguy cơ gian lận;
Phương pháp xác minh sự khác biệt và phát hiện những kẻ gian lận này cũng có thể nhanh chóng tìm ra lỗi trong quá trình tính toán mà không cần so sánh toàn bộ kết quả tính toán (bắt đầu từ nút gốc của cây Merkle và đi xuống từng bước). Rất hiệu quả cho các tác vụ tính toán quy mô lớn.
Tóm lại, mục tiêu thiết kế của lớp khuyến khích/xác minh của Gensyn.ai là: đơn giản và hiệu quả. Tuy nhiên, hiện tại nó chỉ giới hạn ở mức độ lý thuyết và việc triển khai cụ thể có thể gặp phải những thách thức sau:
Trong mô hình kinh tế, làm sao thiết lập các tham số phù hợp để có thể ngăn chặn gian lận một cách hiệu quả mà không đặt ngưỡng quá cao đối với người tham gia.
Về mặt triển khai kỹ thuật, làm thế nào để xây dựng một bằng chứng lý luận mã hóa định kỳ hiệu quả cũng là một vấn đề phức tạp đòi hỏi kiến thức về mật mã nâng cao.
tiêu đề cấp đầu tiên
4. Nghĩ về tương lai
Câu hỏi ai cần một mạng điện toán phi tập trung vẫn chưa được xác minh. Việc áp dụng sức mạnh tính toán nhàn rỗi để đào tạo mô hình quy mô lớn đòi hỏi tài nguyên sức mạnh tính toán khổng lồ rõ ràng là không gian có ý nghĩa nhất và giàu trí tưởng tượng nhất. Nhưng trên thực tế, những nút thắt như giao tiếp và quyền riêng tư khiến chúng ta phải suy nghĩ lại:
Có thực sự hy vọng cho việc đào tạo phi tập trung của các mô hình lớn không?
Nếu nhảy ra khỏi sự đồng thuận “kịch bản hạ cánh hợp lý nhất” này, liệu việc áp dụng sức mạnh tính toán phi tập trung vào việc đào tạo các mô hình AI nhỏ cũng là một kịch bản lớn. Từ quan điểm kỹ thuật, các yếu tố hạn chế hiện tại đã được giải quyết do kích thước và kiến trúc của mô hình.Đồng thời, từ quan điểm thị trường, chúng tôi luôn cảm thấy rằng việc đào tạo các mô hình lớn sẽ rất lớn từ nay đến tương lai, nhưng thị trường mô hình AI cỡ nhỏ Chưa hấp dẫn?
Tuyên bố miễn trừ trách nhiệm: Tất cả các bài báo của Foresight Ventures không nhằm mục đích tư vấn đầu tư. Đầu tư là rủi ro, vui lòng đánh giá mức độ chấp nhận rủi ro cá nhân của bạn và đưa ra quyết định đầu tư một cách thận trọng.
Reference
https://www.together.xyz/blog/neurips-2022-overcoming-communication-bottlenecks-for-decentralized-training-12
https://www.together.xyz/blog/redpajama
https://docs.gensyn.ai/litepaper/
https://www.nvidia.com/en-in/deep-learning-ai/solutions/large-language-models/
https://indiaai.gov.in/article/training-data-used-to-train-llm-models
Giới thiệu về tầm nhìn xa
Foresight Ventures đặt cược vào sự đổi mới của tiền điện tử trong vài thập kỷ tới. Nó quản lý nhiều quỹ: quỹ VC, quỹ quản lý hoạt động thứ cấp, FOF đa chiến lược, quỹ S có mục đích đặc biệt "Quỹ thứ cấp dự đoán l", với tổng quy mô quản lý tài sản là hơn 4 Một trăm triệu đô la Mỹ. Foresight Ventures tuân thủ khái niệm "Độc đáo, Độc lập, Tích cực, Lâu dài" và cung cấp hỗ trợ rộng rãi cho các dự án thông qua các lực lượng sinh thái mạnh mẽ. Nhóm của nó đến từ các nhân sự cấp cao từ các công ty tài chính và công nghệ hàng đầu bao gồm Sequoia China, CICC, Google, Bitmain, v.v.
Website: https://www.foresightventures.com
Tuyên bố miễn trừ trách nhiệm: Tất cả các bài báo của Foresight Ventures không nhằm mục đích tư vấn đầu tư. Đầu tư là rủi ro, vui lòng đánh giá mức độ chấp nhận rủi ro cá nhân của bạn và đưa ra quyết định đầu tư một cách thận trọng.